KISIA AI 교육 정리
최근에 KISIA에서 주관하는 AI 기초 교육을 수강하였고, 주요 내용을 간략히 간추려 본다.
KISIA(한국정보보호산업협회)에서 AI 기초 교육 과정을 (3일간, 무료) 개설하였기에 참가 신청하여 선정이 되었고, 이번에 교육을 받고 관련 내용들을 간단히 정리해 본다.
단 3일 만에 AI의 거의 전체 과정을 다루다 보니 (아마 대학교 전공 과정에서 족히 1년 과정은 될 듯) 아주 압축 요약을 하면서 빠르게 훑어 지나갈 수밖에 없었겠지만, 나는 기존에 유튜브 등으로 학습해 둔 것이 있어서 무지한 상태에서 들은 것은 아니었고, 교육 과정도 Colab으로 상당 부분을 실습하는 방식이어서 나름 유익한 강좌였다.
(참고로 교육 과정에서는 교재로 진행하였고, 원본 PPT 자료는 공유해주지 않았으므로, 아래 그림들은 교재에 있던 그림들과는 조금 다름)
Perceptron
-
단층 퍼셉트론(Single-Layer Perceptron)
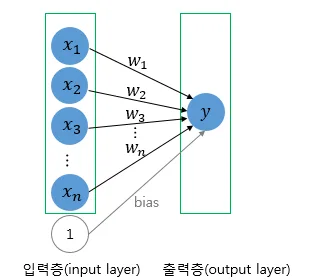
단층 퍼셉트론을 이용하면 아래와 같이 2개의 입력에 대한 AND, OR, NAND 게이트의 구현이 가능하다.
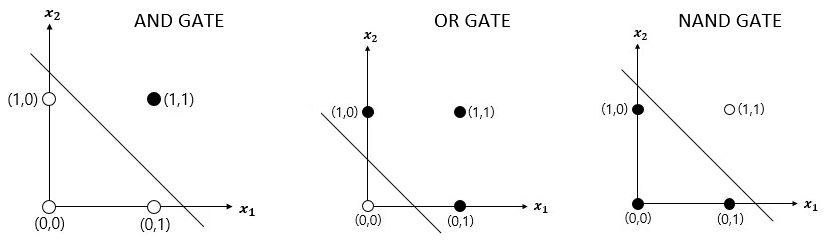
- AND 게이트 파라미터 예: w1 = 0.5, w2 = 0.5, b = -0.7
- OR 게이트 파라미터 예: w1 = 0.6, w2 = 0.6, b = -0.5
- NAND 게이트 파라미터 예: w1 = -0.5, w2 = -0.5, b = 0.7
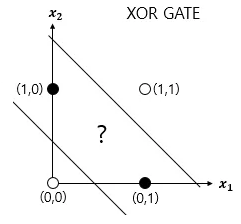
하지만, 단층 퍼셉트론을 사용하면 XOR 게이트는 구현할 수 없는데, 이유는 아래와 같이 직선 1개로는 XOR를 구분할 수 없기 때문이다.
-
다층 퍼셉트론(Multi-Layer Perceptron)
XOR 게이트는 기존의 NAND, OR, AND 게이트를 조합하면 만들 수 있다. 즉, 퍼셉트론 관점에서 말하면 층을 더 쌓으면 만들 수 있다. 이와 같이 입력층과 출력층 사이에 은닉층(hidden layer)이 두는 것이 다층 퍼셉트론이다. 예를 들어서 XOR 게이트는 아래와 같이 은닉층을 1개 만들면 구현할 수 있다.
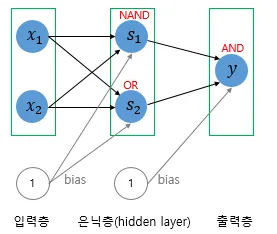
더 어려운 문제를 풀기 위해서 아래와 같이 은닉층을 여러 개 추가하여 다층 퍼셉트론을 구축할 수 있다.
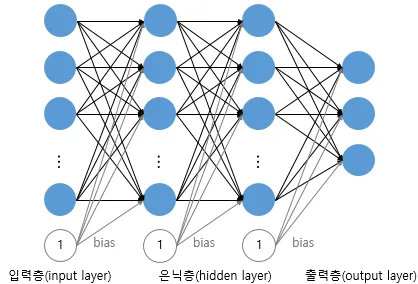
위와 같이 은닉층이 2개 이상인 신경망을 DNN(Deep Neural Network) 이라고 부른다.
활성화(Activation) 함수
활성화(Activation) 함수의 필요성과 조건
신경망에서 층(layer)만 깊게 여러 개 쌓는 것은 단순 선형 중첩이 되고, 아래와 같이 아무리 은닉층이 많아도 수학적으로 단 하나의 선형 함수(y=wx)로 축약된다.
${y = (W_3 * W_2 * W_1) x}$ ⇒ ${y = W’x}$
즉, 선형 변환의 중첩은 결국 선형 변환일 뿐이다.
그래서 인공 신경망에서는 비선형(non-linearity)을 부여하기 위하여 각 층마다 활성화 함수는 두고, 따라서 이 활성화 함수는 비선형 함수이어야 한다.
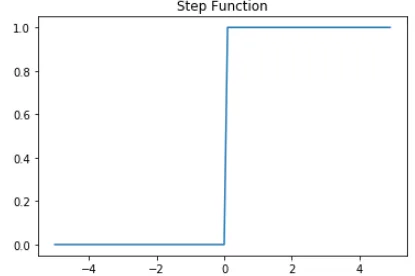
- Step function: 미분이 불가능해 DNN의 오차 학습(역전파)에 사용 불가
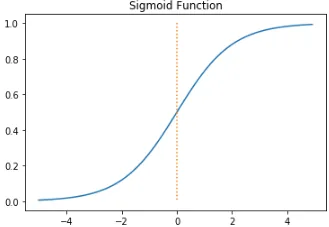
- Sigmoid function: 0~1 사이로 값을 압축, 확률 예측에 좋으나 양극단에 미분값(기울기)이 0에 수렴하는 단점이 있음
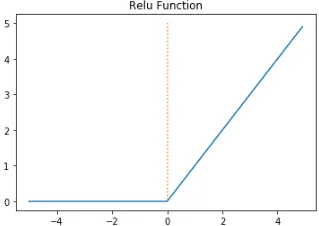
- ReLU(Rectified Linear Unit): 딥러닝에서 가장 보편적으로 사용됨, 계산이 빠르고 양수 구간에 기울기가 죽지 않아 딥러닝 학습 가능
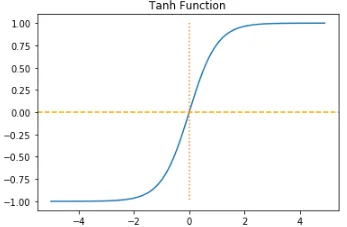
- Hyperbolic tangent function (Tanh function): -1~1 사이의 값을 가짐
Regression(회귀)
- Linear Regression: 예측에 많이 사용됨
- 단순 선형 회귀 분석(Simple Linear Regression Analysis)
y = wx + b - 다중 선형 회귀 분석(Multiple Linear Regression Analysis)
y = w1x1 + w2x2 + … + wnxn + b
- 단순 선형 회귀 분석(Simple Linear Regression Analysis)
- Logistic Regression: 이진 분류에 많이 사용됨
- 이진 분류(Binary Classification) 문제를 풀기 위한 대표적인 알고리즘
- 이진 분류시 x와 y의 관계를 표현하기 위해서는 직선을 표현하는 함수가 아니라 (직선을 사용할 경우 보통 분류 작업이 제대로 동작하지 않음),
S자 형태로 표현할 수 있는 함수가 필요하다. 예를 들어, 출력이 0과 1사이의 값을 가지면서 S자 형태로 그려지는 함수로 Sigmoid 함수가 있다.
- Softmax 회귀: 다중 분류에 많이 사용됨
딥 러닝의 학습 방법
- 순전파(Forward Propagation): 결과로 최종 예측값이 계산됨
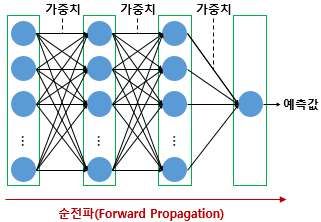
- 방향: 입력층 → 은닉층 → 출력층
- 역할: 주어진 가중치로 입력 데이터를 연산하여 최종 예측값을 도출
- 역전파(Backward Propagation): 결과로 weight와 bias가 수정됨 (학습)
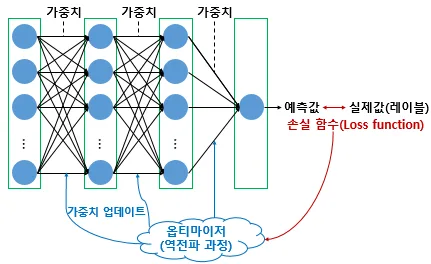
- 방향: 출력층 → 은닉층 → 입력층
- 역할: 예측값과 실제 정답의 차이(오차)를 바탕으로, 각 가중치가 오차에 얼마나 기여했는지 계산하여 가중치를 수정(학습)
- 출력층에서 입력층 방향으로 계산하면서 가중치를 업데이트한다. 그런데 여러 층이 중첩되어 있으므로 각 층을 거슬러 올라가며 ‘부분 미분값’을 곱해서 (편미분), 최종 오차에 대한 특정 가중치의 정확한 global gradient(경사도, 기울기)를 계산한다.
$\displaystyle \frac{dz}{dx} = \frac{dz}{dy} \times \frac{dy}{dx}$
- 손실 함수(Loss Function)
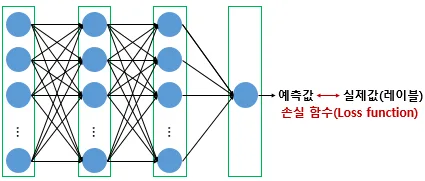
손실 함수는 실제값과 예측값의 차이를 수치화해주는 함수이다. 이 두 값의 차이 즉, 오차가 클수록 손실 함수의 값은 크고 오차가 작을수록 손실 함수의 값은 작아진다.
손실 함수로 회귀에서는 MSE, 분류 문제에서는 Cross-Entropy를 주로 사용한다.
손실 함수의 값을 최소화하는 두 개의 매개변수인 가중치와 bias의 값을 찾는 것이 딥 러닝의 학습 과정이므로 손실 함수의 선정은 매우 중요한다.- MSE(Mean Squared Error) 함수: 선형 회귀, 연속형 변수를 예측할 때 사용된다.
- Binary Cross-Entropy 함수: 출력층에서 이진 분류(Binary Classification)를 할 때 사용된다.
- Categorical Cross-Entropy: 출력층에서 softmax 함수를 사용하는 다중 클래스 분류(Multi-Class Classification)일 경우에 사용된다.
손실 함수의 값을 줄여나가면서 학습하는 방법은 어떤 옵티마이저를 사용하느냐에 따라 달라진다. 옵티마이저에는 다음과 같은 것들이 있다.
- SGD(Stochastic Gradient Descent): 확률적 경사 하강법
- Momentum: 경사 하강법에 관성을 더하는 방식
- Adagrad: 모든 매개변수에 동일한 학습률(learning rate)을 적용하는 대신에 매개변수에 서로 다른 학습률을 적용시키는 방식
- RMSprop: Adagrad 단점을 개선
- Adam: RMSprop와 Momentum을 합친듯한 방식, 빠른 수렴 속도와 안정적인 성능으로 현재 가장 널리 사용됨
DNN(Deep Neural Network)
- DNN은 은닉층을 2개이상 지닌 학습 방법을 뜻한다. 즉, NN과 DNN의 차이점은 다음과 같다.
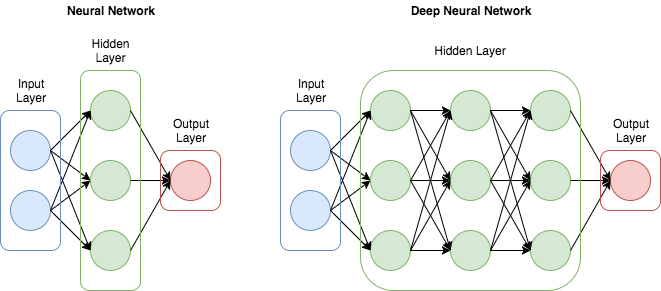
- DNN은 학습해야 할 값(=파라미터)이 엄청나게 많아지고, 새로운 데이터는 잘 못 맞출 수 있다(과적합 문제).
- 또, 공간(예: 이미지), 시간(예: 음성)처럼 구조가 중요한 데이터에는 약하다.
CNN(Convolutional Neural Network)
- CNN Explainer 참조
- Convolutional Layer
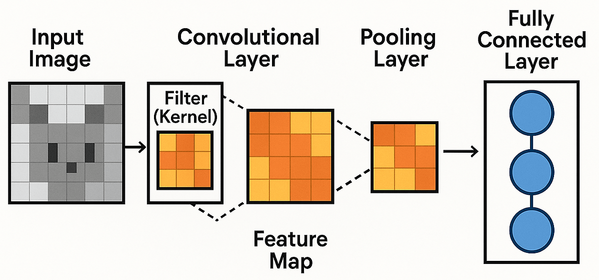
- Convolution Layer: 작은 창(filter, 혹은 kernel)을 이미지에 이리저리 움직이며(슬라이딩), 특정한 패턴을 찾아낸다.
- Pooling Layer: 추출된 특성(Feature Map)의 크기를 줄이는 단계로, 예로 Max Pooling은 가장 큰 것만 남긴다.
- 데이터의 특징을 추출하여 (이미지의 경우 이미지의 특징을 추출) 특징들의 패턴을 파악하는 구조로, convolution 과정과 pooling 과정을 통해 진행된다. Convolution Layer와 Pooling Layer를 복합적으로 구성하여 알고리즘을 만든다.
- 이미지의 경우, 위치와 모양이 조금 달라도 잘 인식하고, 복잡한 이미지도 층을 쌓아가며 점점 더 높은 수준으로 이해시킬 수 있다.
- 단, 시간적 순서가 중요한 정보는 처리하지 못 한다.
RNN(Recurrent Neural Network)
- RNN은 아래 그림에서 좌측과 같이 화살표로 사이클을 그려서 재귀 형태로 표현하기도 하고, 우측과 같이 사이클을 그리는 화살표 대신 여러 시점으로 펼쳐서 표현하기도 한다.
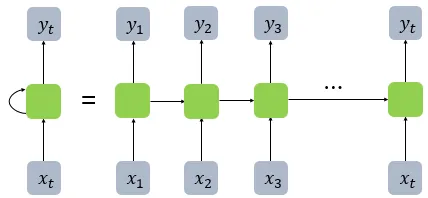
또는 아래와 같이 표현할 수도 있다.
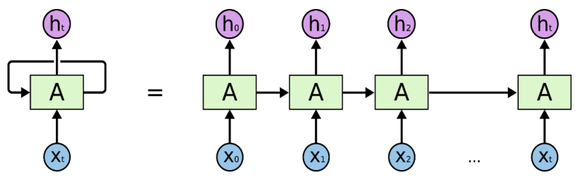
위에서 초록색 box는 메모리 cell 또는 RNN cell이라고 부른다. 메모리 cell이 출력층 방향 또는 다음 시점인 t+1의 자신에게 보내는 값을 은닉 상태(hidden state)라고 한다. 즉, t 시점의 메모리 cell은 t-1 시점의 메모리 cell이 보낸 은닉 상태값을 t 시점의 은닉 상태 계산을 위한 입력값으로 사용한다. - 순환 신경망으로 기억을 가지고 문맥을 파악할 수 있다.
- 은닉층의 출력값을 출력층으로만 보내는 것이 아니라, 다시 동일한 은닉층의 다음 시점 입력으로 보내는 순환 루프를 가지는 네트워크이다.
- 데이터를 하나씩 순서대로 받아들이면서, 이전까지 기억한 정보를 함께 참고한다. 즉, 지금의 정보만 보는 게 아니라 “과거에 뭘 봤는지”도 함께 고려한다.
- 반복적이고 순차적인 데이터 학습에 특화된 인공신경망의 한 종류로써 내부의 순환구조가 들어있다는 특징을 가지고 있다. 순환구조를 이용하여 과거의 학습을 weight를 통해 현재 학습에 반영한다.
- 현재의 학습과 과거의 학습의 연결을 가능하게 하고 시간에 종속된다는 특징도 가지고 있다.
- 음성 웨이브폼을 파악하거나, 텍스트의 앞 뒤 성분을 파악할 때 주로 사용된다.
- 단어나 숫자의 순서가 중요한 경우 잘 작동하고, 문맥 유지가 가능하다.
- 그러나 time step이 길어질수록 앞의 정보가 뒤로 충분히 전달되지 못하는 현상이 발생하여, 앞에서 본 정보가 너무 오래 지나면 기억이 희미해지고, 긴 문장이나 복잡한 대화에선 초반 정보를 잘 활용하지 못하는 문제가 발생한다.
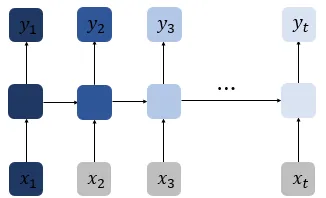
위 그림과 같이 첫번째 입력값인 x1의 정보량을 짙은 남색으로 표현했을 때, 색이 점차 얕아지는 것으로 시점이 지날수록 x1의 정보량이 손실되어가는 과정을 보여준다. 뒤로 갈수록 x1의 정보량은 손실되고, 시점이 충분히 긴 상황에서는 x1의 전체 정보에 대한 영향력은 거의 의미가 없어질 수도 있다.
LSTM(Long Short-Term Memory)
- 순환 신경망(RNN)의 한 형태로, LSTM은 정보를 오랫동안 기억하는 것이 가능하게 하며, 이는 긴 시퀀스 데이터 처리에 특히 유용하다.
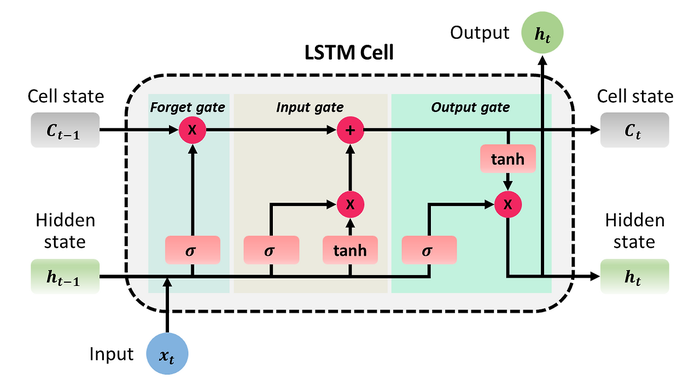
- LSTM은 은닉층의 메모리 셀에 ‘게이트’라는 구조를 추가하여 정보의 흐름을 조절한다. 각 게이트는 셀 상태(cell state)를 업데이트하는 데 어느 정보를 허용할지를 학습하게 된다. 이런 구조 덕분에 LSTM은 RNN이 어려워하는 장기 의존성 문제를 해결하는데 중요한 역할을 한다.
- 기본적인 RNN에 비해 gradient 소실 문제를 효과적으로 해결하는 것으로 알려져 있고, RNN과 비교하여 긴 시퀀스의 입력을 처리하는 데 탁월한 성능을 보인다.
- LSTM cell: 아래와 같이 forget gate, input gate, output gate로 구성된다.
NLP(Natural Language Processing)
- 전통적인 언어 모델에서 자연어 처리는 텍스트 시퀀스의 확률 분포를 학습하고, 이를 통해 자연스러운 문장을 생성하는 것을 의미한다. 현대에는 딥러닝 방법으로 확률을 뉴럴 네트워크가 근사하고, 전체 문맥을 self-attention 기법으로 학습시킨다.
- 자연어 처리를 위한 데이터 준비
자연어 처리에서는 텍스트를 비정형 형식에서 정형 형식으로 변환하기 위해 다음과 같은 기법을 사용한다.
- 토큰화: 통상적으로 이는 자연어 처리를 위한 텍스트 처리의 첫 번째 단계입니다. 토큰화란 텍스트를 문장 또는 단어로 분할하는 것을 의미한다.
- Word Tokenization: 단어 기반, 어휘 사전의 크기가 매우 커지고, OOV(Out-of-Vocabulary) 문제가 발생한다.
- Character Tokenization: 문자 기반, OOV 문제 해결되지만 단어의 의미 정보가 손실되는 문제가 있다.
- Subword Tokenization: 현대 LLM의 표준이다.
- BPE(Byte Pair Encoding): 데이터 압축을 위해 개발된 알고리즘으로, 가장 빈번하게 등장하는 연속된 바이트(문자) 쌍을 하나의 새로운 단위로 병합하는 과정을 반복한다.
- Unigram Tokenizing: 큰 어휘에서 시작하여 점진적으로 불필요한 토큰을 제거하는 방식으로 최적의 어휘 사전을 구축한다. 이는 각 sub-word가 독립적으로 나타날 확률(Unigram 확률)을 기반으로 문장을 토큰화하는 통계적 접근 방식이다.
- 어간 추출: 이 텍스트 정규화 기법은 단어의 접사를 제거하여 단어를 원형으로 줄인다. 어간 추출에서는 단순한 발견적 규칙을 사용하며 이로 인해 유효하지 않은 사전 단어가 생성될 수 있다.
- 표제어 추출: 이 정교한 텍스트 정규화 기법은 어휘 및 형태소 분석을 사용하여 단어의 접사를 제거한다. 예를 들어, “building has floors”는 “build have floor”로 줄어들게 된다.
- 불용어(stop word) 제거: ‘for’나 ‘with’처럼 문장에 중요한 의미를 더하지 않는 단어를 제거한다.
- Word2Vec: 단어 임베딩 기법 중 가장 널리 사용되는 구현은 Word2Vec 이다.
-
Sparse Representation
은 수십만 개 이상의 아주 긴 벡터로, 벡터의 대부분은 0으로 채워지고 등장하는 단어 위치에만 값이 있다. 해석은 쉬우나 단어 간의 유사도나 의미적 관계를 전혀 담아내지 못한다. 예를 들어 고양이와 강아지의 관계는 고양이와 자동차만큼이나 다른 것으로 취급된다.
-
Dense Representation
은 상대적으로 짧은 저차원 벡터를 사용하고 벡터의 모든 요소가 0이 아닌 실수로 채워지고, 이때 각 숫자는 단어의 특정 의미적 속성을 나타내므로 의미적 관계 표현이 가능해진다.
- Dense Representation 또는 Embedding은 단어의 ‘의미’ 자체를 저차원의 연속적인 숫자 벡터로 압축하는 방식이다. 이 기법은 단어의 분산 표현을 숫자형 벡터로 생성하여 단어의 의미 체계와 단어 간의 관계를 포착한다. 각 단어의 의미 공간 속에 하나의 좌표를 갖게 된다. (예를 들어
"왕 - 남자 + 여자 = 여왕"과 같은 유추 연산이 가능해진다) - Word2Vec의 핵심적인 특징은 단어 간의 의미적 유사성을 벡터 공간에 반영한다는 점이다. 이는 단어의 의미를 단순히 기호가 아닌 실제 의미론적 관계를 가진 존재로 인색하게 하는 패러다임의 전환을 이끌었다.
-
Sparse Representation
- 토큰화: 통상적으로 이는 자연어 처리를 위한 텍스트 처리의 첫 번째 단계입니다. 토큰화란 텍스트를 문장 또는 단어로 분할하는 것을 의미한다.
- AI를 사용한 자연어 처리
언어 데이터로 훈련된 AI 모델은 패턴을 인식하고 문장에서 후속 문자나 단어를 예측할 수 있다. 자연어 처리 모델을 구축하기 위해서는 로지스틱 회귀나 결정 트리 등의 고전적인 머신러닝 알고리즘을 사용하거나 CNN(컨벌루션 신경망), RNN(순환 신경망), 오토인코더 등의 딥러닝 아키텍처를 사용할 수 있다. 예를 들어, CNN을 사용하여 텍스트를 분류하고 RNN을 사용하여 문자 시퀀스를 생성할 수 있다. - 트랜스포머(Transformer) 모델(딥러닝 모델의 일종)은 자연어 처리에 혁신을 가져왔으며, BERT 및 ChatGPT와 같은 LLM(대규모 언어 모델)의 기반이 된다. 트랜스포머는 순차 데이터에서 관계를 추적하도록 설계되었다. 입력과 출력 사이의 전역 종속성을 수집하기 위해 셀프 어텐션 메커니즘을 활용한다. 이를 통해 LLM은 자연어 처리의 맥락에서 장기 종속성, 단어 간의 복잡한 관계 및 자연어에 존재하는 뉘앙스를 포착할 수 있다.
- 대표적인 트랜스포머: BERT는 분석에, GPT는 생성에 더 적합
- BERT(Bidirectional Encoder)
- GPT(Generative Pre-Trained)
LangChain
- LangChain Docs
- LangChain은 대규모 언어 모델(LLM, 예: GPT-4, Claude 등)을 기반으로 실제 애플리케이션을 만들 수 있도록 도와주는 오픈소스 프레임워크이다.
- 복잡한 LLM workflow를 모듈화된 컴포넌트로 구성하고 연결하여, 개발자가 챗봇, 데이터 분석, 자동화된 에이전트 등 정교한 AI 서비스를 더 쉽고 효율적으로 구축할 수 있도록 지원한다.
-
기존의 LLM은 단순한 문장 생성에 그쳤지만, 실제 제품을 만들기 위해서는 다음이 필요하고, LangChain은 이 기능들을 모듈화된 방식으로 제공한다.
필요 요소 LangChain의 역할 외부 데이터 연결 PDF, 웹, DB, API 등 문서를 불러오기 복잡한 처리 흐름 제어 여러 단계의 작업을 연결하고 제어 메모리 유지 대화 이력 기억, 사용자 정보 유지 도구 활용 계산기, 검색 API, 코드 실행 등 외부 툴 사용 - LangChain은 LLM 프롬프트 템플릿, 메모리 등 여러 컴포넌트를 파이프라인처럼 연결하여 작업을 수행하도록 만든다. LangChain에서는 직관적인 구문인 LCEL(LangChain Expressiion Language)을 사용하여 아래 예와 같이 파이프 기호(
|)로 컴포넌트들을 쉽게 연결할 수 있다.[프롬프트 템플릿] → | → [LLM 모델] → | → [출력 파서]
LangGraph
- LangGraph는 복잡하고 동적인 AI 에이전트 애플리케이션 구축을 위해 등장한 강력한 프레임워크이다. 기존 LangChain이 제공하는 순차적인 체인 구조의 한계를 넘어, 보다 유연하고 제어 가능한 에이전트 개발을 가능하게 한다.
- LangGraph는 작업의 흐름을 node와 edge로 구성된 그래프로 표현한다. 각 node는 특정 작업(예: LLM 호출, 도구 사용)을 수행하는 단위이고, edge는 node간의 전환 조건과 데이터 흐름을 정의한다. 조건부 분기, 병렬 처리 등 복잡한 로직을 시각적이고 직관적으로 구현할 수 있다.
- LangGraph의 가장 큰 특징은 중앙 집중화된 상태(state) 객체를 통해 전체 workflow의 데이터를 관리한다는 점이다.